 arkana
Las Crónicas de ZK: El Modelo del Oráculo Aleatorio
Ahora que entendemos el conocimiento cero, debemos tomarnos un tiempo para examinar cómo se comporta bajo no interactividad.
Ahora que hemos aclarado un poco el verdadero significado del conocimiento cero, estamos plenamente preparados para empezar a explorar las técnicas y protocolos que se han hecho su nombre en el entorno ZK en los últimos años.
O eso parece... hasta que nos damos cuenta de que estamos dejando un cabo suelto bastante grande sin atender.
Como adelantamos al final del artículo anterior, todo nuestro análisis detallado sobre las nociones de conocimiento cero y solidez de conocimiento asumía un entorno interactivo, donde el verificador es un actor real, que genera desafíos aleatorios frescos en cada paso. Y sin embargo, en la práctica, ¡casi siempre nos interesan los protocolos no interactivos! Esto significa que en la mayoría de los casos, los protocolos interactivos se convierten a sus contrapartes no interactivas mediante la transformada de Fiat-Shamir.
Como mínimo, eso debería despertar un par de dudas. ¿Cambia algo ahora que no tenemos un verificador con quien interactuar? Y más importante aún, ¿se rompe alguna de nuestras garantías previas en este nuevo entorno?
Este es el asunto que abordaremos hoy. Una vez que lo hagamos, el camino hacia adelante quedará completamente allanado, y podremos avanzar a toda máquina hacia los sistemas ZK modernos.
¡Manos a la obra entonces!
El Riesgo de la No Interactividad
Para empezar, repasemos brevemente cómo funciona la transformación que da inicio a toda esta discusión.
La transformada de Fiat-Shamir (o heurística) es una técnica que le permite a un probador generar una transcripción para un protocolo, sin tener que interactuar nunca con el verificador.
Sin embargo, además de verificar las pruebas, el propio verificador es una pieza integral del proceso de generación de la prueba, porque genera desafíos aleatorios e impredecibles a los que el probador debe responder, y cuyo propósito principal es dificultarle al probador hacer trampa. Por lo tanto, para convertir un protocolo interactivo en uno no interactivo, el probador necesita reemplazar los desafíos aleatorios del verificador por otra cosa.
Pero ¿cómo hacemos eso? Es decir, claro, podríamos simplemente confiar en que el probador elija un desafío aleatorio, ¡pero un verificador no tendría forma de saber si la elección fue realmente aleatoria, o un número fabricado para que la transcripción funcione!
En cierto modo, este nuevo entorno requiere aleatoriedad verificable, por decirlo así. Y da la casualidad de que tenemos una primitiva criptográfica que nos acerca bastante a ese comportamiento: ¡las funciones de hash!
Por ejemplo, en un protocolo Σ, el desafío puede reemplazarse por un hash de (el compromiso con el valor secreto ) y del compromiso inicial de la aleatoriedad , es decir, . ¡El resto del protocolo permanece sin cambios!
Es un cambio de bajo costo y bastante razonable a cambio de un efecto tan poderoso (la capacidad de eliminar la interacción). ¡Y nos acercamos lo máximo posible a un verdadero desafío aleatorio! Así que eso debería bastar, ¿no?
Bueno...
Bueno... no es tan simple.
Aunque las cosas se ven bien en la superficie, no podemos pasar por alto el hecho de que el verificador ahora queda completamente fuera de la ecuación en la generación de la prueba. Esto no es gratis, y plantea una pregunta importante:
¿Puede un probador aprovechar este cambio para producir pruebas válidas sin conocer realmente el testigo?
Eso es algo de lo que antes no teníamos que preocuparnos. El probador ahora tiene el control total: deriva los desafíos haciendo hash de sus propios compromisos, lo que significa que controla todas las entradas del proceso de generación de la transcripción. Y esto... debería al menos preocuparnos.
No hace falta exagerar... pero es seguro decir que esto podría ser un riesgo de seguridad enorme si no se analiza con cuidado.
Entonces, ¿cómo hacemos para responder si esto rompe alguna de nuestras garantías previas?
Bueno, vamos a tener que dar un paso atrás para poder avanzar, y concentrarnos en responder una pregunta crucial: ¿cómo modelamos la seguridad en los sistemas criptográficos?
Modelando a un Adversario
Resulta que modelar la seguridad es bastante simple conceptualmente: ¡literalmente nos imaginamos a alguien intentando romper nuestro sistema con su mejor esfuerzo!
Lo sé, ¡impactante!
En criptografía, a esta entidad hipotética la llamamos adversario, y suele denotarse como .
Es importante señalar que no esperamos que todos los usuarios del mundo real se comporten de una forma tan extrema. Más bien, esta es una manera limpia de analizar la seguridad: si incluso un atacante muy astuto, usando todas las estrategias posibles a su alcance, no puede romper el sistema, ¡entonces podemos tener mucha confianza en su diseño!
El objetivo del adversario es claro: necesita producir una prueba válida sin conocer realmente el testigo. Si logra hacerlo, entonces la solidez de conocimiento queda totalmente demolida. El sistema de pruebas ya no garantizaría que un probador convincente conoce realmente la información secreta detrás del enunciado, ¡lo que ciertamente nos complicaría las cosas!
Por lo tanto, lo que debemos definir son dos cosas. Primero, qué superpoderes o habilidades tiene el adversario a su disposición para lograr su objetivo, y segundo, qué consideramos como romper exitosamente el protocolo.
Y no, con superpoderes no me refiero a disparar láseres.
No, me refiero a algo mucho más simple: estamos tratando de definir qué cosas puede hacer el adversario con las funciones de hash que ejecuta para generar los desafíos. A saber:
- ¿Puede evaluarlas sobre entradas arbitrarias?
- ¿Puede probar muchos compromisos distintos antes de decidirse por uno final?
- ¿Puede adaptar su estrategia en función de salidas de hash anteriores?
Estas son exactamente el tipo de preguntas que necesitamos hacernos. Y para formalizarlo, vamos a necesitar un marco con el cual trabajar.
El Modelo del Oráculo Aleatorio
Hay muchas formas de estudiar el comportamiento de una función de hash en este contexto adversarial, siendo la opción obvia trabajar directamente con funciones de hash reales. Ya sabes, lo de siempre: SHA-256, Keccak, y demás.
Aunque esta parece la elección natural, rápidamente se vuelve extremadamente engorrosa. Todas estas funciones son algoritmos complicados, y demostrar garantías de seguridad precisas sobre su comportamiento está mucho más allá de lo que podemos hacer de forma práctica y realista.
Además, ¡cada función de hash necesitaría su propio análisis dedicado!
Así que, en cambio, adoptamos un enfoque distinto: analizaremos la seguridad en un entorno idealizado, al que llamamos el Modelo del Oráculo Aleatorio (o ROM, por sus siglas en inglés).
A pesar del nombre elegante, el modelo es bastante básico. Todo lo que hacemos es pensar en una función de hash como una caja negra mágica, llamada oráculo aleatorio, que cualquiera puede consultar entregándole una entrada, a la cual el oráculo responde con una salida completamente aleatoria.
Recuerda, ¡este es un modelo idealizado! Sabemos que la salida de un hash en realidad no es aleatoria, sino pseudoaleatoria (o impredecible).
Y dado que esto es una idealización de un hash, también exigimos una condición extra: si se consulta la misma entrada dos veces, el oráculo debe devolver la misma salida que antes.
Este oráculo está disponible para todos en el sistema, incluyendo al adversario. Puede consultarlo tantas veces como quiera, adaptar sus consultas en función de las respuestas anteriores, y usar esos resultados en cualquier estrategia que desee.
En esencia, este oráculo aleatorio reemplaza efectivamente al verificador como fuente de impredecibilidad. Lo que lo convierte en la herramienta perfecta para formalizar nuestro análisis de la transformada de Fiat-Shamir.
Oráculo aleatorio, listo. ¿Qué sigue?
Un Juego Adversarial
Ahora podemos volver a enfocar nuestra atención en responder nuestra pregunta original: ¿puede un adversario aprovechar la transformada de Fiat-Shamir para falsificar pruebas?
Nuevamente, querremos idear un marco formal para esto. Y en criptografía, preguntas como esta suelen plantearse como juegos.

En nuestro caso, enfrentamos a un adversario contra un verificador . El adversario intentará producir una transcripción que aceptaría, a pesar de no conocer el testigo. Y las reglas son:
- recibe acceso de oráculo al oráculo aleatorio .
- puede consultar sobre cualquier entrada que elija.
- Eventualmente, produce una transcripción .
- El verificador recalcula el desafío , y comprueba si la ecuación de verificación se cumple.
Si la transcripción es aceptada, decimos que el adversario gana el juego. ¡Así de simple!
Habiendo planteado las cosas de esta manera, nuestra pregunta de seguridad ahora se vuelve muy precisa: ¿cuál es la probabilidad de que un adversario pueda ganar este juego?
En pocas palabras, si existe un adversario eficiente que tiene éxito con probabilidad no despreciable, entonces el protocolo se clasifica como inseguro, porque significaría que se pueden producir pruebas convincentes sin el conocimiento real que las respalde.
Por supuesto, lo contrario también es cierto: si todo adversario eficiente tiene una probabilidad despreciable de ganar, entonces nuestro protocolo conserva su solidez de conocimiento.
¡Muy bien! ¿Qué tipo de estrategias podría usar un adversario para intentar hacer trampa?
Estrategias Adversariales
En nuestro simple ejemplo de protocolo Σ (después de aplicar Fiat-Shamir), la primera estrategia candidata obvia sería trabajar hacia atrás a partir del valor del desafío.
Digamos que elegimos algunos valores y . Usando estos valores, podemos ver que despejar en el paso de verificación del protocolo de Schnorr es bastante directo:
Pero no hay mucho más que podamos hacer después, porque también debe satisfacer:
Por cierto, de aquí en adelante me quedaré con la notación , característica del protocolo de Schnorr, por simplicidad. ¡Pero ten en cuenta que otros protocolos tendrán otras entradas para !
Como y se eligen al azar, es muy improbable que el valor calculado de produzca casualmente . Lo mejor que un adversario podría esperar es una coincidencia muy afortunada, lo que, según las reglas de nuestro juego, significa que el protocolo es seguro frente a esta estrategia.
Esa bien podría ser el final de la historia, pero...
Parece que nos estamos perdiendo algo, porque la estrategia en sí (que, si recuerdas del artículo anterior, es exactamente cómo se comporta un simulador) no va a funcionar. Pero ¿qué pasa si subimos un poco las apuestas? Aunque no conozcamos los detalles, podemos imaginar un adversario lo suficientemente astuto como para burlar nuestras defensas, ¡y aun así producir una transcripción válida!
Por lo tanto, lo que hacemos es asumir que tal adversario existe. Si hacemos eso, entonces el problema de demostrar que la transformada de Fiat-Shamir es segura se reduce muy bien a una forma mucho más manejable: ¡todo lo que tenemos que hacer es demostrar que esta suposición lleva a una contradicción!
Para esto, sin embargo, debemos abstenernos de imaginar a este adversario como un tipo sospechoso sentado frente a varias pantallas con una capucha negra.
Más bien, es mucho más conveniente pensar en el adversario como un algoritmo ejecutable al que denotaremos . Puede que no conozcamos sus detalles internos, pero aun así sabemos qué debería hacer el algoritmo: elegir un compromiso inicial , consultar al oráculo aleatorio tantas veces como sea necesario, y finalmente producir una transcripción válida , todo ello sin tener acceso al testigo secreto.
Y esta formalización es todo lo que necesitamos para llegar a nuestra contradicción.
Engañando al Adversario
Muy bien, ya tenemos el algoritmo . Lo ejecutamos una vez, y obtenemos una transcripción aceptante . ¿Qué hacemos ahora?
Bueno, sabemos una cosa con certeza: sin importar qué estrategia use el adversario, si finalmente logra producir una transcripción que pasa la verificación, eso significa que el valor debe ser igual a . Y como el adversario no conoce de antemano la salida del oráculo, la única forma en que podría haber obtenido ese valor es consultando al oráculo con la entrada en algún momento durante su ejecución, ¿verdad?
En otras palabras: ¡todo ataque exitoso debe involucrar una consulta al oráculo aleatorio cuya salida sea el desafío presente en la transcripción final!
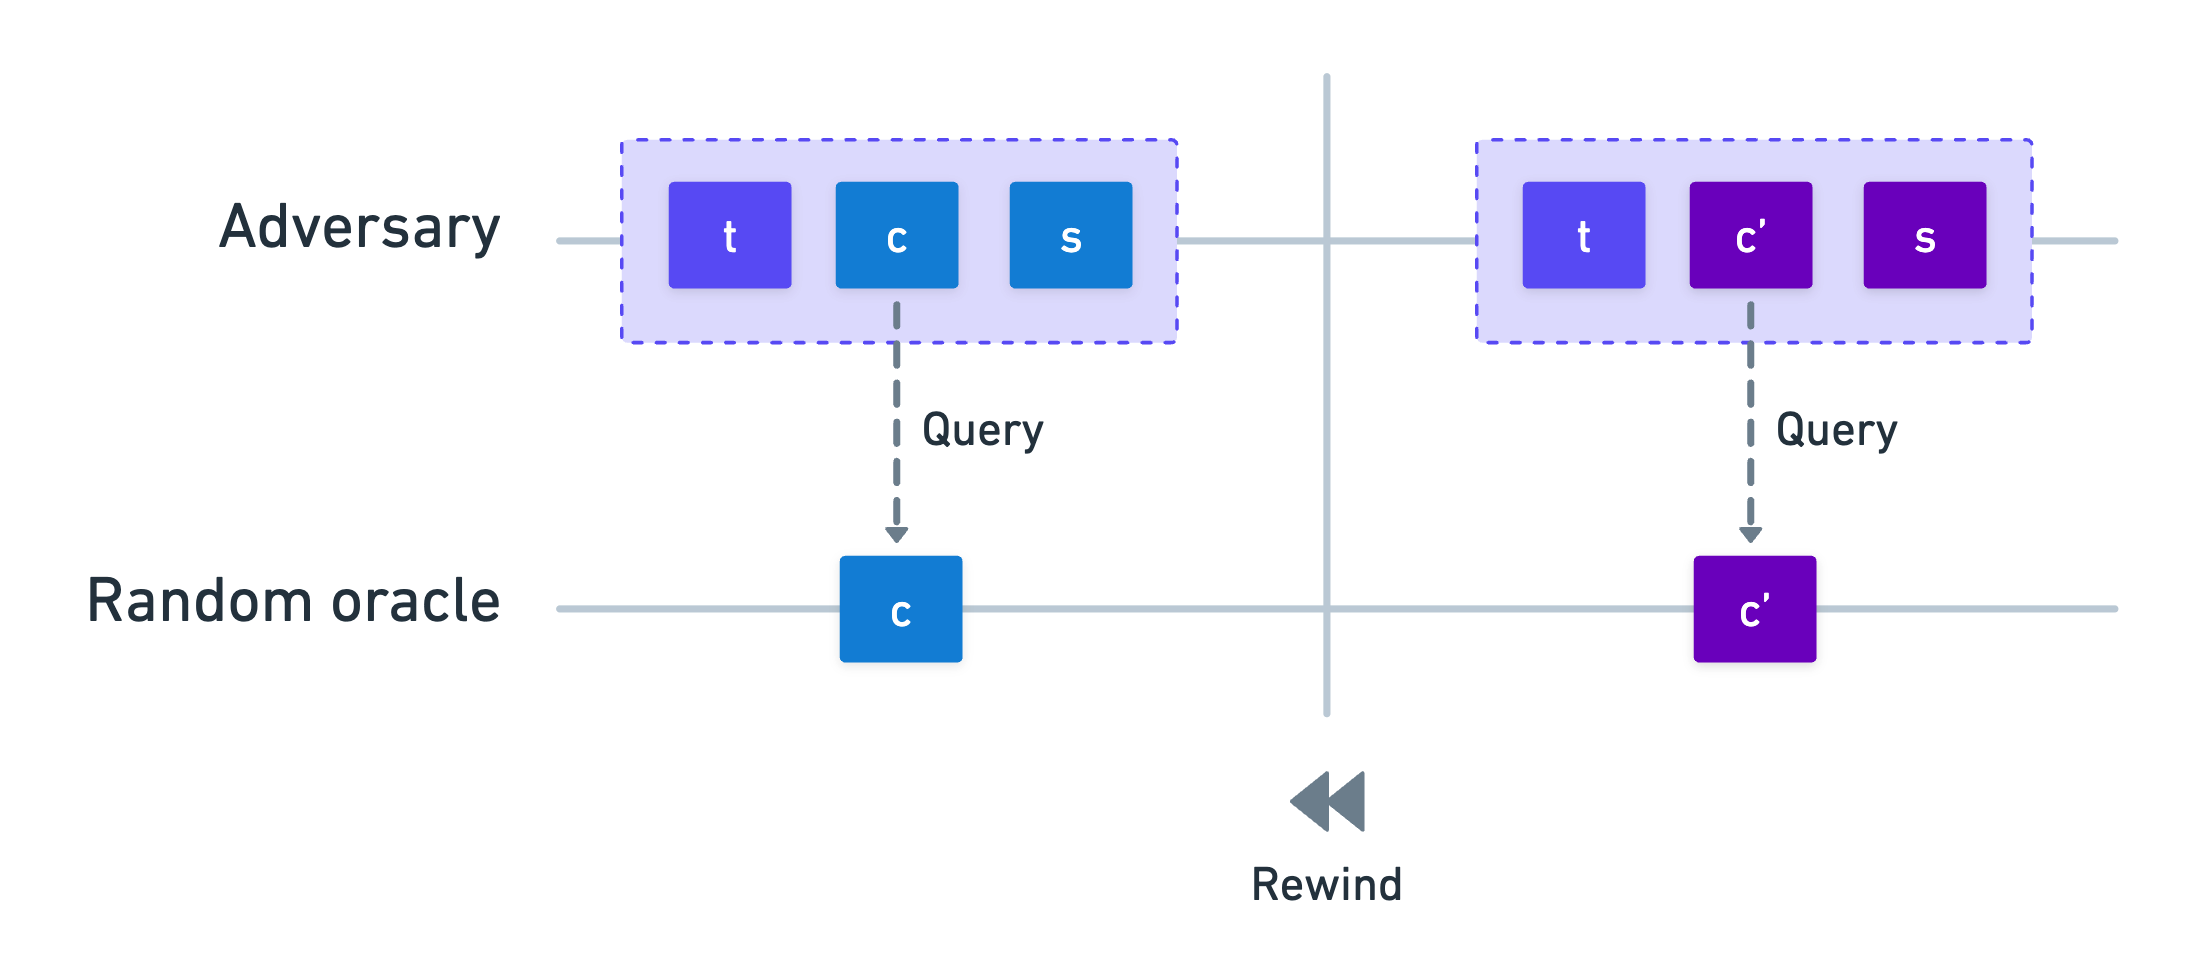
Puede parecer bastante obvio, pero podemos sacarle provecho, y aquí es donde el ROM realmente brilla. Verás, como sabemos qué consulta va a hacer el adversario, ¿qué pasaría si ejecutamos el algoritmo una segunda vez, pero cambiando la respuesta de por algún desafío distinto ?
Nuevamente, asumiendo que el adversario tiene alguna estrategia eficiente desconocida a su disposición, debería poder producir otra transcripción aceptante , sin saber que cambiamos la respuesta del oráculo aleatorio.
Así que, en este punto, tenemos dos transcripciones aceptantes para el mismo compromiso, con desafíos distintos. Pero espera, ¿eso no significa que...?
¡Exacto, lo que estabas pensando! Como estamos tratando con un protocolo Σ, la solidez especial garantiza que podemos extraer el testigo a partir de las transcripciones y .
Y ahí radica la contradicción: un adversario capaz de falsificar pruebas en el entorno de Fiat-Shamir nos entregaría inmediatamente el testigo mismo. Pero asumimos que el adversario no conoce el testigo, ¡así que no hay nada que extraer!
Ese es el principio central en juego: si podemos reejecutar el algoritmo del adversario y ajustar algunos resultados de consultas en el camino, deberíamos poder extraer del adversario información que en realidad no conoce, lo cual ni siquiera debería ser posible.
Este mecanismo de ejecutar dos veces desde el mismo estado inicial, interceptando una única consulta al oráculo y cambiando su respuesta, es lo que formalmente se llama rebobinado (rewinding). Es simplemente otra forma de pensar en lo que estamos haciendo: rebobinamos la ejecución hasta el punto donde se hizo la consulta al oráculo aleatorio, y cambiamos la respuesta.
Y esta capacidad de rebobinar es lo que garantiza la solidez de conocimiento de la transformada de Fiat-Shamir, bajo este entorno ROM con el que estamos trabajando.
Por supuesto, protocolos más complejos pueden necesitar más de dos ejecuciones para lograr una extracción exitosa, por lo que la formalización de este argumento para protocolos arbitrarios requiere un poco más de trabajo. Realmente no es necesario que nos sumerjamos en ello, porque la intuición es la misma: ejecutar, rebobinar, y repetir hasta poder extraer el secreto.
Aunque si tienes curiosidad, la formalización se conoce como el Lema de Bifurcación (Forking Lemma).
¿Y el Conocimiento Cero?
¡Genial! Hemos demostrado que la solidez de conocimiento sobrevive a la transformada de Fiat-Shamir. Pero si algo aprendimos del artículo anterior, ¡es que esto es solo la mitad de la historia!
Todavía queda una preocupación importante por atender: ¿qué pasa con el conocimiento cero en sí?
Recordemos que todo el análisis de conocimiento cero se construyó alrededor de la noción de simulador: un algoritmo capaz de producir transcripciones válidas sin conocimiento del testigo, que operaba eligiendo primero y al azar, y luego calculando hacia atrás a partir de esos valores.
Como ya discutimos, este truco choca inmediatamente contra un muro en nuestro nuevo entorno, porque el verificador recalculará , y comprobará que coincida con la transcripción. Si el oráculo aleatorio realmente responde como un oráculo aleatorio, entonces es muy improbable que esta estrategia tenga éxito.
Pero ya hemos estado jugueteando con las respuestas del oráculo, ¿no? ¿Podríamos usar el mismo truco otra vez?
¡Efectivamente! Verás, el ROM trata en realidad de controlar la salida del oráculo aleatorio a nuestra conveniencia.
Es un modelo que se sitúa en el punto medio entre las funciones de hash puras, y un verificador real que puede elegir sus desafíos con astucia.
Por lo tanto, esto nos da exactamente la herramienta que necesitamos. El simulador no solo consulta al oráculo: ¡puede controlar su salida! Así que, antes de que se ejecute cualquier cosa, el simulador puede simplemente programar la respuesta del oráculo para la consulta sobre de modo que sea el valor que ya eligió.
A esto a veces se lo llama la programabilidad del oráculo aleatorio, y es una de las características más importantes que hacen del ROM un modelo tan útil.
Con eso en mano, la estrategia de simulación es casi idéntica a la del caso interactivo: elegir y al azar, calcular , luego programar el oráculo para que devuelva ante la entrada consultada esperada (en este caso, ), y producir . Y así, sin más, obtenemos una transcripción aceptante, indistinguible de una real, ¡sin conocimiento alguno del testigo!
¡Fácil!
Resumen
Y con esto cerramos finalmente el capítulo de hoy, y damos respuesta a nuestras preguntas en torno a Fiat-Shamir. ¿Sobreviven las garantías en el entorno no interactivo? En el Modelo del Oráculo Aleatorio, ¡la respuesta es sí!
Los dos argumentos que vimos son elegantemente simétricos:
- Para el conocimiento cero: el simulador no solo consulta al oráculo, sino que lo programa, fijando la respuesta de antemano para producir una transcripción falsa consistente que es indistinguible de una real.
- Para la solidez de conocimiento: toda falsificación exitosa debe involucrar una consulta específica al oráculo, y rebobinar al adversario con una respuesta distinta en ese punto nos permite extraer el testigo, lo cual es una contradicción directa.
O en una sola línea:
En el ROM, la programabilidad del oráculo preserva el conocimiento cero, mientras que su observabilidad preserva la solidez de conocimiento
En el camino, también recogimos algunas herramientas reutilizables: el ROM como marco idealizado para el análisis de seguridad, la formulación de ataques basada en juegos, y el argumento de rebobinado que verás una y otra vez en las demostraciones de solidez.
Como siempre, hay mucho más por decir. El ROM es una idealización, después de todo, y las funciones de hash reales no son verdaderos oráculos aleatorios.
Estudiar Fiat-Shamir con funciones concretas es un área de investigación activa, y depende de una propiedad llamada correlation intractability, ¡que está bastante más allá del alcance de este artículo!
Aun así, la intuición que construimos hoy debería ser la conclusión principal: aunque eliminar al verificador también elimina la verdadera fuente de aleatoriedad, hacerlo puede seguir siendo perfectamente válido.
Con estas últimas piezas en su lugar, el camino por delante está finalmente allanado para que pasemos al reino de los sistemas modernos de conocimiento cero.
Y comenzaremos este último tramo del viaje con algo que hemos estado posponiendo desde hace bastante tiempo: ¡cómo convertir circuitos en polinomios!
¡Hasta entonces!
¿Te resultó útil este contenido?
Apoya a Frank Mangone enviando un café. Todos los ingresos van directamente al autor.