 arkana
Las Crónicas de ZK: SNARKs (Parte 2)
Ahora miramos una segunda técnica para construir SNARKs que apunta a arreglar algunas de las falencias de nuestra exploración anterior.
La última vez, finalmente llegamos a ver nuestro primer protocolo de conocimiento cero eficiente, en la forma de Groth16. Lo llamamos un SNARK por sus características: tamaño de prueba pequeño, verificación rápida, y no interactivo.
Eso si, fuimos muy cuidadosos en reconocer siempre el principal punto débil del protocolo: cada circuito requiere su propia ceremonia de preprocesamiento (o setup) confiable. Si cambias una sola compuerta o agregas un solo cable, tendrás que pasar por una ceremonia completamente nueva: un ritual multiparty complejo y que consume tiempo, donde dependes de que al menos un participante sea lo suficientemente honesto como para destruir su fragmento del residuo tóxico.
En un entorno controlado, esto puede ser tolerable. Pero en producción, donde los desarrolladores pueden necesitar iterar sobre los circuitos regularmente, esto tiene el potencial de convertirse en un cuello de botella serio y también en un problema de seguridad serio.
Así que nos hicimos una pregunta: ¿podemos hacerlo mejor?
La respuesta claramente es sí (sino este artículo no existiría). La construcción que logró esto, propuesta en 2019 por Ariel Gabizon, Zachary Williamson y Oana Ciobotaru, lleva uno de los acrónimos más maravillosamente retorcidos de toda la criptografía: PLONK, que significa Permutations over Lagrange-bases for Oecumenical Noninteractive arguments of Knowledge (Permutaciones sobre bases de Lagrange para argumentos de conocimiento no interactivos ecuménicos).
Sí, tranquilo, lo sé. ¿Qué demonios es "ecuménico" de todos modos? Cebooolla loco...
Por supuesto, este artículo usa la técnica de aritmetización Plonkish que vimos un par de artículos atrás, así que la publicación logró presentar no una, sino dos contribuciones increíbles a la comunidad ZK.
¡Descubramos cómo lo hicieron!
Limitaciones Actuales
Antes de poder apreciar lo que PLONK hace distinto, está bueno preguntarnos: ¿no se puede modificar Groth16 para usar un setup universal?
Entender por qué esto no es posible nos dará algunas pistas sobre qué podemos hacer distinto en este nuevo sistema de argumentos que estamos por presentar.
Volvamos un momento a la construcción de la clave de prueba en Groth16. Para cada cable del circuito, el setup se comprometía a un valor de la forma:
Esos términos , , son los polinomios QAP que derivamos de las matrices R1CS del circuito, evaluados en el secreto. Como se descarta justo después del setup, esas evaluaciones necesitan calcularse durante la ceremonia, con el circuito en mano.
Y ahí yace el problema de raíz: no podemos recalcular estos polinomios después de que se descarta, así que sorteamos esta limitación incorporando esas evaluaciones directamente en la cadena de referencia estructurada (SRS).
Una analogía rápida podría ayudar: es como forjar una llave a medida para una cerradura específica, y luego destruir la forja. La llave es perfecta para esa cerradura e inútil para todas las demás, ¡y de alguna manera no puedes construir otra copia de la llave sin la forja!

Idealmente entonces, si tuviéramos una forma de calcular estas evaluaciones durante la generación de la prueba y la verificación (implícitamente, porque sigue siendo residuo tóxico, pero supongo que se entiende la idea), podríamos tener lo que necesitamos para encontrar un setup universal.
PLONK logra esto usando una aritmetización completamente distinta, una cuya estructura polinomial no depende del circuito al momento de la ceremonia. La SRS se convierte simplemente en un conjunto común y corriente de potencias de KZG:
Sí, spoiler: ¡vamos a usar KZG!
No hay nada específico del circuito ahí dentro. La ceremonia ocurre una sola vez, y soportará cualquier circuito de tamaño máximo (compuertas). La descripción del circuito vivirá por separado, como un conjunto de polinomios públicos calculados a partir del circuito, comprometidos usando la SRS.
¡Y ya hemos explorado cómo se ve la aritmetización que habilita esto! Así que hagamos un breve repaso.
Repaso de Plonkish
En lugar de codificar un circuito en tres matrices dispersas (como en R1CS), Plonkish lo organiza como una tabla densa de traza de ejecución. Cada fila corresponde a una compuerta, y consiste en exactamente tres columnas de cables: una entrada izquierda , una entrada derecha , y una salida .
| Compuerta # | Entrada izquierda | Entrada derecha | Salida |
|---|---|---|---|
| 1 | |||
| 2 | |||
| 3 | |||
| 4 | |||
| 5 |
Uno de los problemas que identificamos de inmediato fue que, aunque evitamos las matrices dispersas de R1CS, esta tabla no captura el tipo de cada compuerta. No podemos saber si estamos mirando una compuerta de suma o de multiplicación solo con ver los valores.
Para arreglar esto, introdujimos las columnas de selectores. Estas eran un conjunto de columnas extra que viven junto a las columnas de cables, y contienen un puñado de selectores escalares que determinan qué relación debe cumplirse entre , y para esa fila específica. Y como generalización, definimos esta plantilla de restricción, que usa todos esos selectores:
Eligiendo los valores correctos para los selectores, podemos expresar cualquier compuerta estándar. Por ejemplo:
| Tipo de compuerta | |||||
|---|---|---|---|---|---|
| Suma | |||||
| Multiplicación | |||||
| Constante |
Es una plantilla lisa y llana, ¡pero tiene suficiente expresividad para representar casi cualquier circuito! Honestamente, me parece bastante hermoso.
Y ojo, no estamos limitados a estos cinco selectores. Como ya mencioné antes, los descendientes de PLONK (TurboPlonk, UltraPlonk, Halo2) extienden esta idea con compuertas personalizadas que codifican operaciones complejas en una sola fila. Imagina que pudieras codificar la suma de puntos de una curva elíptica (que tomaría decenas de restricciones R1CS) en una sola fila de la tabla.
Las posibilidades son infinitas, ¡pero no nos adelantemos!
Al final, sin embargo, esta tabla sigue siendo solo eso: una tabla con valores. Para construir un sistema de pruebas a partir de ella, vamos a necesitar algunas cosas más. Y usualmente, el siguiente paso es intentar hablar el lenguaje de los polinomios.
Entonces, ¿cómo hacemos eso?
Codificación Polinomial
Nuestra estrategia será codificar la pregunta de si una traza de ejecución es válida en identidades polinomiales. Mientras dichos polinomios satisfagan ciertas relaciones, la ejecución es válida, y si no, entonces no lo es. Esta reducción de la satisfacibilidad de circuitos a chequeos polinomiales es lo que hace posibles a los SNARKs.
Y no olvidemos: siempre hay un planteo subyacente de pertenencia a un lenguaje y la relación NP de la que hablamos la última vez.
La idea es que el probador tendrá la traza de ejecución completa, que es nuestro testigo privado , y quiere probar que corresponde a una ejecución válida. En este caso, es la descripción del circuito en sí más cualquier entrada pública que el verificador conozca.
Así que lo que intentamos hacer puede resumirse limpiamente de la siguiente manera: ¡estamos tratando de transformar una pregunta de pertenencia a un conjunto en un chequeo sobre identidades polinomiales!
Para esta parte de la historia, vamos a necesitar recurrir a unos elementos viejos y conocidos: las raíces de la unidad. Las usaremos para interpolar algunos polinomios, y al hacerlo, obtenemos una representación que es amigable con la FFT, y más importante aún, independiente de la estructura del circuito al momento del preprocesamiento. Esto es lo que habilita el setup universal: la SRS no necesita saber nada sobre el circuito, porque estamos trabajando en un dominio de evaluación genérico que cualquier circuito puede usar.
Veamos cómo. Supongamos que tenemos un circuito con un total de compuertas. Para trabajar con él, elegiremos las raíces -ésimas de la unidad como nuestro dominio de evaluación. Usándolas como entradas, podemos interpolar cada columna de nuestra tabla de evaluación, asignando a cada fila una evaluación de la forma . Esto resultará en un polinomio de grado a lo sumo que pasa por cada uno de los valores de una columna.
Así, por ejemplo, pasará por los puntos para cada fila de la tabla.
Una vez que terminemos de interpolar, tendremos un conjunto de polinomios , , , , , , , . Y lo bueno de ellos es que satisfacen nuestra restricción de compuerta de antes - así que esto se convierte en una identidad polinomial que debe cumplirse en cada :
Es importante notar que estos polinomios tienen roles diferentes.
Los polinomios de cables , , codifican el testigo privado del probador, por lo que cambian con cada prueba. Sin embargo, los polinomios selectores , , , , son parámetros públicos derivados puramente de la estructura del circuito. Se calculan una vez durante una fase de preprocesamiento, y son los mismos para cada ejecución de este circuito.
Esta separación es crucial: ¡los selectores definen lo que el circuito chequea, mientras que los cables contienen lo que el probador afirma!
En este punto, usaremos un truco familiar: si esta relación se cumple en cada raíz de la unidad, entonces esas son precisamente los ceros o raíces del polinomio del lado izquierdo. Lo que significa que el polinomio anulador:
divide exactamente al polinomio de antes, dándonos un polinomio cociente :
¿Te suena familiar?
Debería, ¡ya que es el mismo truco de divisibilidad que usamos en las relaciones QAP! Y podemos usar prácticamente el mismo razonamiento de antes: una traza de ejecución válida producirá un lado izquierdo que es perfectamente divisible por .
Cómo encaja esto en el protocolo PLONK completo? Lo vamos a ver un poco más adelante, pero ya todo se ve bastante encaminado.
Excepto que hay un problema.
Conectando los Cables
Antes mencionamos que la representación en tabla es densa y eficiente, pero tiene una enorme brecha estructural: los valores de los cables se repetirán entre filas. Cuando las compuertas se conectan, la salida de una alimenta las entradas de otras - y si una compuerta se ramifica (es decir, la salida está conectada a múltiples compuertas), ese valor aparece en múltiples lugares.
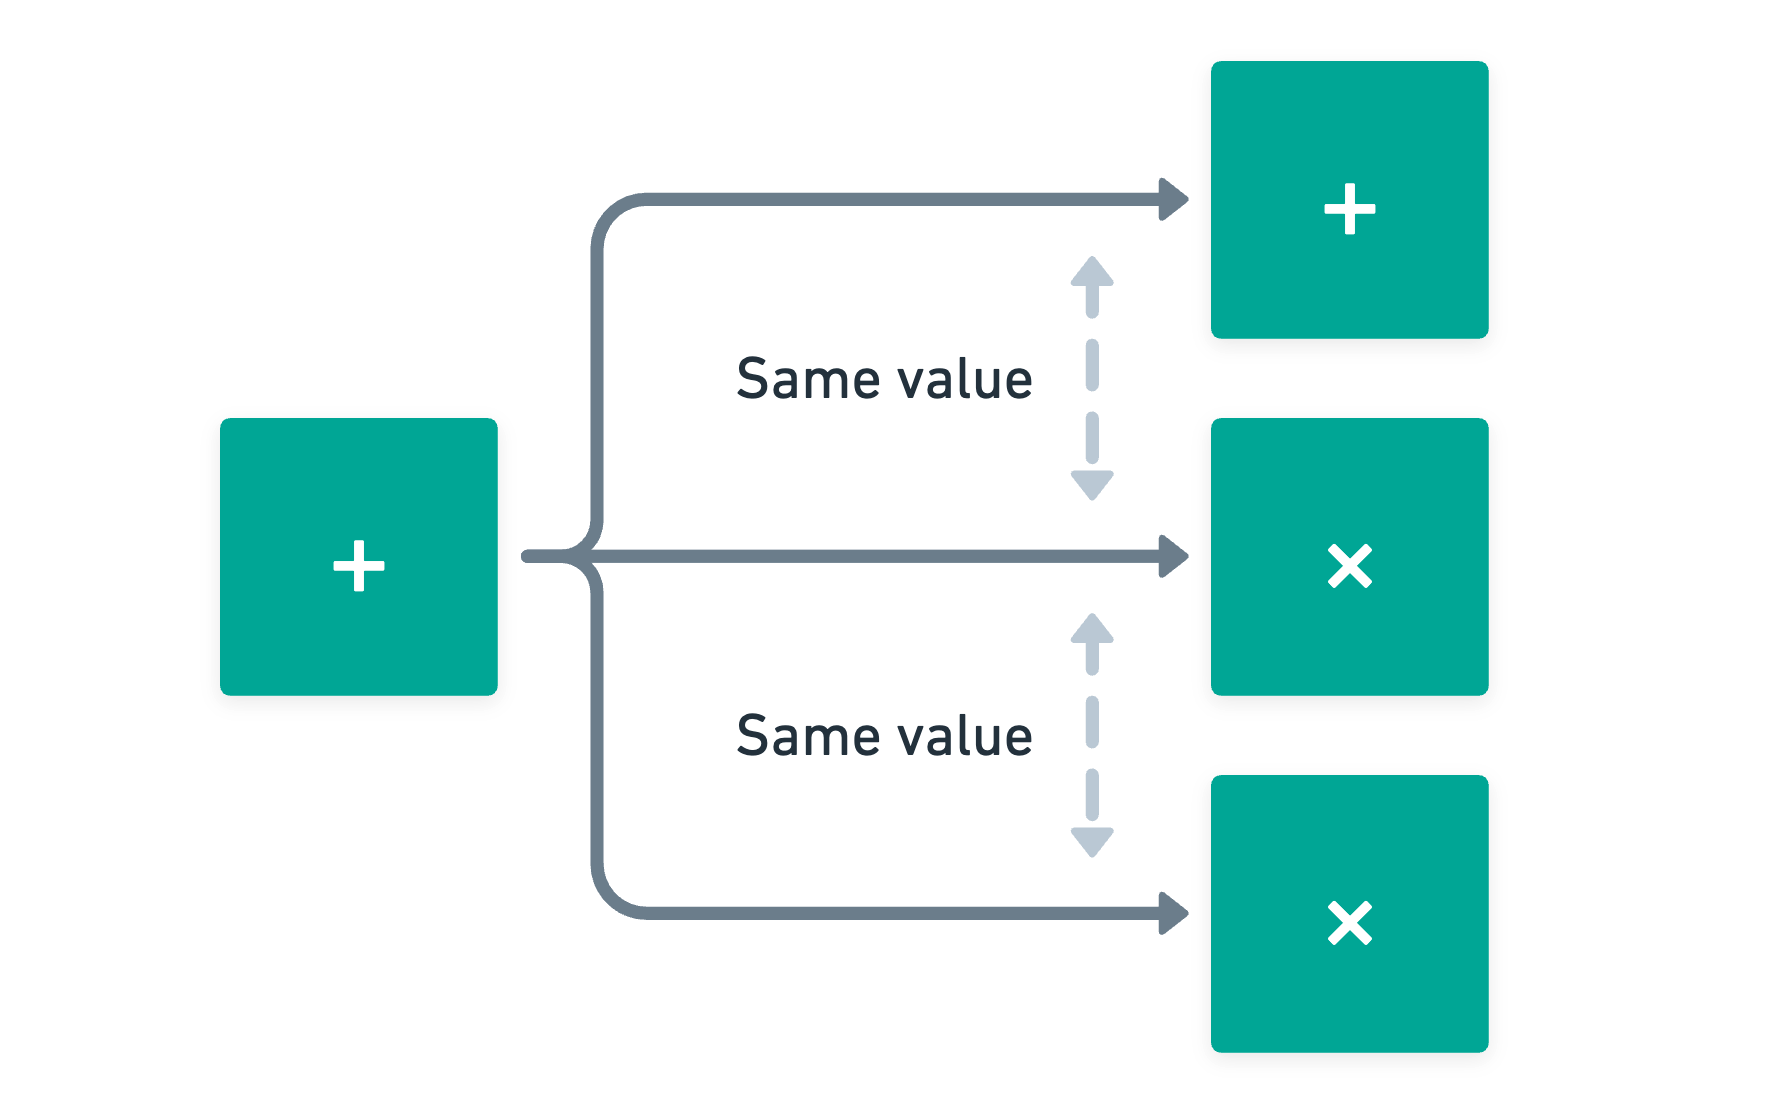
El problema es que cada fila verifica la consistencia de una única compuerta de forma aislada. Dos celdas de la tabla pueden tener valores diferentes para el mismo cable, porque dos compuertas pueden realmente estar conectadas con el mismo cable. El cableado es ahora implícito en lugar de estructural.
Si no nos ocupamos de esta limitación, echará por tierra cualquier esfuerzo posterior, y por eso necesitamos introducir un nuevo conjunto de restricciones, que llamamos restricciones de copia. Hacerlas cumplir es en realidad de lo que trata la construcción central de PLONK - y también de donde viene su nombre tan peculiar.
Permutaciones al Rescate
Para representar la noción de "el cable y el cable tienen el mismo valor" en términos polinomiales, primero necesitamos una manera de acceder a los valores individuales de las celdas. La forma estándar de hacerlo es asignando a cada celda de la tabla una etiqueta única. Con tres columnas y filas, eso hace etiquetas en total.
¡Notemos que estas etiquetas forman su propio espacio, distinto de nuestras raíces -ésimas de la unidad!
Ahora, imaginemos por un segundo que tenemos un polinomio que codifica cada valor de celda en su etiqueta:
Esto nos da un marco limpio con el cual trabajar: las celdas que deben tener valores iguales se convierten en un conjunto de etiquetas que deberían tener evaluaciones coincidentes. Por ejemplo:
Ingenuamente, podríamos chequear estas igualdades una por una. Lamentablemente, eso escala linealmente con el tamaño del circuito. Y como estamos tratando de construir un SNARK (lo que significa prueba pequeña y verificación rápida), eso claramente no sirve.
Entonces, ¿es este un callejón sin salida?
¡Para nada! Y de hecho, aquí es precisamente donde la magia de PLONK aparece en escena: hay un truco ingenioso para chequear todas las igualdades de un conjunto de una sola vez.
El truco es usar una permutación .
¿Una qué?
¡Una permutación! Es simplemente una pequeña función con un trabajo simple: ciclar a través de las etiquetas de cada conjunto de restricciones. Así que si aparece en las celdas , entonces crea el ciclo :
Notemos que las permutaciones dependen de la estructura del circuito, así que también se calcularán durante una fase de preprocesamiento del circuito, ¡y serán públicas!
Con las permutaciones en mano, ahora podemos hacer esta afirmación elegante:
Todas las restricciones de copia se cumplen si y solo si el multiconjunto de valores en las posiciones originales es igual al multiconjunto de valores en las posiciones permutadas.
Tranquilo, tranquilo, no entres en pánico. Yo te cubro.
Un multiconjunto es simplemente una colección donde los duplicados importan. Por ejemplo, {3, 3, 7} y {3, 7, 7} son multiconjuntos diferentes. La afirmación simplemente dice: si recolectamos todos los valores de los cables y luego los recolectamos de nuevo después de permutar las etiquetas, obtenemos la misma bolsa de valores (con las mismas cantidades), solo si las celdas restringidas realmente tienen valores iguales.
Para construir algo de intuición sobre cómo chequear esto (que también nos llevará a la solución real propuesta en PLONK), tomemos todas las etiquetas de algún conjunto y calculemos el producto de los valores de los cables:
Ahora, ¿puedes adivinar qué pasa cuando aplicamos la permutación?
Bueno, como simplemente cicla a través del conjunto de etiquetas, ¡obtenemos exactamente el mismo producto!
Lamentablemente, esto por sí solo no es suficiente. Mirando más de cerca esos productos, probablemente surja una pregunta: ¿no funcionaría esto para cualquier conjunto de cables, iguales o no?
Y tendrías toda la razón, ¡funcionaría! Así que para que esto funcione solo cuando los valores de los cables son verdaderamente idénticos, necesitamos un ingrediente más. Todo lo que tenemos que hacer es mezclar las etiquetas mismas:
Ese pequeño parche hace que estos productos sean iguales si y solo si todos los valores coinciden. La clave está en esa sutil discrepancia en el segundo producto: la etiqueta no coincide con la entrada de . Cuando los valores difieren, este desfase destruye la igualdad.
¡Puedes probar esto tú mismo con una pequeña lista de valores, y cualquier estrategia de indexado!
Con esto, podemos decir con confianza que el multiconjunto ya no es invariante bajo la permutación, a menos que, por supuesto, todos los valores sean realmente el mismo.
Y la cereza del postre: ¡podemos chequear esta igualdad eficientemente!
El Producto Acumulado
En lugar de calcular ambos productos enormes de una vez y compararlos, el probador usará una estrategia diferente: construirá la razón incrementalmente usando lo que llamamos un polinomio de producto acumulado (a veces llamado el producto global).
Pensemos en como un acumulador: registra cómo se equilibran el numerador y el denominador a medida que recorremos la tabla, fila por fila.
En este punto, necesitamos dejar de pensar en términos de , y volver a nuestros polinomios de traza originales , y . Solo necesitábamos para construir algo de intuición, pero la codificación real de los cables vive en esos tres polinomios.
Lo que significa que en la fila , tenemos valores de cables , , . Y podemos empezar a acumular resultados una compuerta a la vez, así:
Donde es la "identidad", y mapea cada celda a su etiqueta en el espacio de etiquetas, y codifican las respectivas permutaciones. ¡De nuevo, todo esto es parte de un paso de preprocesamiento!
Claro, esa expresión por sí sola no se equilibra... pero ¿qué pasa una vez que hemos cubierto cada una de las compuertas del circuito?
Lo que pasará es que una vez que lleguemos a , contendrá la contribución de cada compuerta en el numerador, y la permutación correspondiente a cada uno de esos términos en el denominador. ¡Y si todas las restricciones de copia se cumplen, entonces todos esos términos se cancelarán al final!
Así, el probador (que está a cargo de calcular ) fijará , y luego comenzará un procedimiento iterativo procesando una fila a la vez, obteniendo los valores de , , y así sucesivamente. Cada uno de esos valores acumulará la razón asociada con la compuerta particular que se está procesando, así que al llegar a , deberíamos obtener la cancelación completa, ¡lo que significa que !
Quizás esto no sea tan fácil de ver, así que me gustaría proponer un pequeño ejercicio si tienes tiempo: ¡recorre nuestro circuito de ejemplo paso a paso! Ver la cancelación en la práctica podría ayudarte a convencerte de que esto efectivamente funciona.
¡Y esa es la idea general! Por supuesto, todavía necesitaríamos transformar esto en una identidad polinomial que podamos chequear. Antes de hacerlo, sin embargo, debo contarte un pequeño secreto: hay un problema muy sutil con este argumento tal como lo hemos definido. ¡Vamos a tener que hacernos cargo de él antes de continuar!
Una Pequeña Salvedad
Verás, después de todo, este es un producto enorme. Y hay un único número que no se lleva muy bien con esta noción de acumular contribuciones: ¡el cero!
El cero prácticamente significaría un desastre. Piénsalo: ¿qué pasa si algún término del producto resulta ser cero? En el numerador, haría que todo el producto sea cero, pero sería un problema aún más desastroso en el denominador, porque estaríamos dividiendo por cero.
Lo cual, por supuesto, rompe absolutamente el argumento.
Por suerte para nosotros, todo este desastre puede evitarse de una manera muy simple: ¡simplemente agregar algo de aleatoriedad a la mezcla!
Además de , le pediremos al verificador que emita un desafío aleatorio extra , y lo sumaremos a cada término de nuestro producto, así:
Al hacer esto, estamos desplazando cada uno de esos valores por algún valor aleatorio, haciendo extremadamente improbable que alguno de los términos del producto sea igual a cero.
¡Crisis evitada con éxito!
Bueno, en realidad mentí un poco antes: ¡ hace más que evitar los ceros! Sin él, un probador tramposo a veces puede elegir valores de cables que rompen las restricciones de copia y aun así lograr que ambos productos coincidan. Incorporar cierra ese resquicio. No hace falta que se preocupen por los detalles ahora, pero tengan en cuenta que esto es muy importante al discutir la solidez en detalle.
La Identidad Polinomial
Por último, lo que necesitamos hacer es construir la identidad polinomial para chequear este argumento de permutación. Así que después de que el probador toma todos los valores calculados e interpola el polinomio , hay un total de dos identidades polinomiales que podemos construir a partir de él.
A la primera la podemos llamar restricción de paso: cada paso debe coincidir con lo que vemos en el producto acumulado. Eso significa que, si reorganizamos un poco:
Notemos que usamos una propiedad de las raíces de la unidad ahí: ¡ es una forma ingeniosa de obtener cuando !
La segunda identidad es la restricción de frontera, que simplemente dice que una vez que hemos recorrido los pasos, deberíamos recuperar . Pero aquí podemos hacer una linda observación: como es un grupo cíclico, , así que . ¡Eso significa que la condición de cierre y la condición de inicialización son lo mismo! Y por lo tanto, una única restricción es suficiente:
Donde es la base de Lagrange que vale en , y en cualquier otro punto de .
¡De aquí viene en realidad la otra parte del nombre PLONK!
Entonces, comenzamos con el valor semilla , y la restricción de paso lo lleva hacia adelante a través de las filas. En la última fila, la restricción de paso da la vuelta naturalmente porque , cerrando el ciclo sin necesidad de ninguna condición extra.
Y ahí lo tienes: cada restricción de copia del circuito, sin importar cuántas sean, está codificada en dos polinomios y , ¡y apenas dos identidades polinomiales!
Bastante elegante, ¿no?
Agrupando los Chequeos
Antes de ensamblar el protocolo completo, hay un truco más que vale la pena describir.
Ahora mismo, tenemos tres identidades polinomiales separadas que el probador necesita probar: las restricciones de compuerta de antes, y la flamante restricción de permutación y la restricción de frontera .
Claro, podríamos manejarlas por separado. Pero hay un enfoque aún mejor: combinarlas en un único chequeo, usando lo que llamamos una combinación lineal aleatoria.
¡Este es un truco similar al que vimos en GKR!
Para esto, el verificador envía un desafío aleatorio , y el probador construye un único polinomio cociente:
Si analizas las tres condiciones, resulta que comparten el mismo conjunto de raíces, . Por lo tanto, sumar , y (o cualquier combinación lineal de ellos) resulta en un polinomio que preserva las raíces originales, así que podemos dividirlo por el mismo polinomio anulador de antes (), ¡y obtener un cociente para el sistema completo!
Esto funciona tan bien porque si alguna de las restricciones individuales falla, lo más probable es que el polinomio no sea divisible por . Eso significa que si evaluamos en un punto aleatorio, hay una probabilidad altísima (cortesía del lema de Schwartz-Zippel) de que la identidad polinomial no se cumpla.
Esto se ve reforzado además por el hecho de que es un desafío aleatorio. Si no lo fuera, el probador podría intentar falsificar algún valor de que haga funcionar la evaluación de la identidad polinomial, ¡y eso no lo queremos!
Agrupar ahorra tanto tamaño de prueba como tiempo de verificación: en lugar de chequear tres identidades polinomiales separadas, chequeamos solo una.
Supongo que este es un buen momento para dar un paso atrás y hacer una panorámica de lo que hemos logrado hasta ahora. Empezamos con un circuito y una relación NP , y hemos reducido la afirmación del probador de que su traza de ejecución es un testigo válido para este circuito a una única identidad polinomial agrupada que chequea todo de una sola vez, mediante una simple prueba de divisibilidad.
Se siente casi imposible, ¡pero la matemática funciona! Y ese es exactamente el poder de los sistemas de pruebas algebraicos: podemos reducir afirmaciones computacionales complejas a elegantes chequeos polinomiales.
Juntando Todo
¡Genial! Básicamente tenemos todos los ingredientes ahora, ¡así que es hora de ensamblar el sistema de pruebas!
Lo primero que ocurre es la fase de preprocesamiento a la que hemos aludido varias veces a lo largo del artículo. Los polinomios selectores y los polinomios de permutación se derivan de la estructura del circuito, y se comprometen usando la SRS. Es importante notar que las salidas de esta fase son parámetros públicos: no son parte del testigo, y crucialmente, cualquiera puede calcularlos de forma independiente.
Esto significa que el probador, el verificador, o cualquier tercero puede hacer este preprocesamiento, ya que tanto la descripción del circuito como la SRS son completamente públicas.
En la práctica, esto se hace una vez y los resultados se distribuyen, pero no se requiere confianza aquí, ya que la derivación es determinista. Esto es también lo que hace universal al setup: cualquier circuito puede producir su propio conjunto de parámetros públicos a partir de la misma SRS.
Una vez superado el preprocesamiento, el probador procede a ejecutar el circuito, y obtiene una traza de ejecución completa. Lo que quiere hacer a continuación es convencer al verificador de que tanto las restricciones de compuerta como las de copia se cumplen.
El enfoque aquí es permitirle al verificador chequear las identidades polinomiales por su cuenta. Para que esto suceda, el probador se comprometerá a un montón de polinomios usando compromisos KZG, de modo que el verificador pueda consultarlos en valores de su elección.
Por fin, ¡algo que se siente sencillo!
Este baile de comprometer-desafiar-abrir tiene un nombre formal: es una instancia de una Prueba de Oráculo Interactiva Polinomial (PIOP, por sus siglas en inglés, o simplemente IOP). El probador se compromete a polinomios como "oráculos" que el verificador puede consultar en puntos elegidos, el verificador emite desafíos aleatorios, y el probador responde con aperturas respaldadas por pruebas. PLONK es, en su núcleo, un PIOP - y no será el último que veamos.
Y así, podemos por fin presentar la parte interactiva del protocolo. Va así:
- Compromiso del testigo: El probador interpola , , a partir de su traza de ejecución, y se compromete a ellos usando KZG: , , .
- Iniciar el argumento de permutación: el verificador responde con desafíos aleatorios y . El probador los usa para calcular el polinomio acumulador y se compromete a él: .
- Calcular el cociente: el verificador envía el desafío . El probador lo usa para agrupar las restricciones (como vimos en la sección anterior) y calcular el polinomio cociente , comprometiéndose a él: .
- Consultas polinomiales: el verificador envía un punto de evaluación aleatorio . El probador abre todos los polinomios comprometidos en (y también en , para el chequeo de valores consecutivos). KZG provee las pruebas de apertura.
- Chequear las identidades polinomiales: con las aperturas, el verificador reconstruye las identidades polinomiales en y chequea que se cumplan. Por Schwartz-Zippel, ¡si todo cuadra en este punto aleatorio, significa que las identidades polinomiales completas se cumplen con probabilidad abrumadora!
Y ahora si, ¡eso es todo! Fácil, ¿no?
Sí, supongo que no es nada fácil superar todos los obstáculos del camino, ¡pero una vez que tenemos todas las piezas, juntarlas no se siente como una tarea tan descabellada!
En general, el proceso termina siendo un poco más complejo que Groth16. Y supongo que esto plantea una pregunta obvia: ¿realmente vale la pena el problema extra?
Pros y Contras
Como siempre, hay algunas compensaciones a considerar.
Primero que nada, ahora usamos un setup universal. Esta es una de las características más importantes de PLONK, hecha posible por la elección de KZG como el esquema de compromiso polinomial. ¡Solo necesitamos ejecutar una única ceremonia para derivar la SRS, y todos los circuitos del mundo quedan cubiertos!
¡Siempre y cuando el tamaño del circuito no exceda la longitud de la SRS!
En esta misma línea, podemos hablar de flexibilidad. Esta es la otra gran victoria de PLONK: podemos extender la plantilla de selectores a nuestro gusto, lo que puede dar lugar a todo tipo de optimizaciones. ¡Sistemas como Halo2 han convertido esta extensibilidad en nada menos que una forma de arte!
Luego, tenemos el tamaño de la prueba para discutir. Aquí, PLONK pierde contra Groth16: una prueba típica de PLONK tendrá alrededor de 15 elementos, cuando contamos todos los compromisos y las pruebas de apertura. Esto sigue siendo sucinto por cualquier medida razonable. Es solo que la compacidad de Groth16 es bastante difícil de superar.
Y por último, tenemos el costo de verificación. En este frente, Groth16 y PLONK están bastante cerca, ya que ambos necesitan una cantidad pequeña (constante) de cálculos de emparejamientos. La verificación de PLONK es un poco más complicada debido al chequeo de permutación, pero sigue siendo rápida e independiente del tamaño del circuito, que es nuestro requisito.
En resumen: Groth16 gana en compacidad de la prueba, y PLONK gana en flexibilidad y conveniencia del setup. Dependiendo del caso de uso, podríamos necesitar inclinarnos hacia una de las dos opciones.
¡Decisiones, decisiones!
Resumen
Y con eso, ¡hemos cubierto la mayor parte de PLONK!
Iba a decir "eso es PLONK en pocas palabras", pero creo que sería bastante forzado, ¡dada la complejidad y el alcance de esta pieza de criptografía!
Construyendo sobre la aritmetización Plonkish de un par de artículos atrás, PLONK logra proveer un setup universal, válido para cualquier circuito hasta cierto tamaño.
La idea clave es que la descripción del circuito (los polinomios selectores y las permutaciones) se mantiene fuera de la SRS. La ceremonia y la SRS se convierten en una capa de infraestructura en lugar de un requisito por circuito.
Salteé intencionalmente una prueba rigurosa de conocimiento cero y de solidez de conocimiento. También pasamos por encima de algunos de los detalles más finos. Estos son cruciales si estamos implementando el protocolo, pero como estamos tratando de cubrir los conceptos centrales, ¡creo que está bien omitirlos aquí!
Como siempre, hay mucho más para decir. El artículo original de PLONK es en realidad bastante accesible, y con el contexto que tienes después de leer esto, debería serlo todavía más.
También está el libro de Halo2, un excelente recurso para ver cómo se usa Plonkish en la práctica.
PLONK y sus descendientes son el principal caballito de batalla que impulsa a los sistemas de pruebas ZK. Más precisamente, la aritmetización Plonkish (y sus extensiones) se ha vuelto muy popular. ¡Lo que significa que esta es una base sólida para entender el panorama actual de ZK!
Todo lo que construimos hoy depende de una única herramienta haciendo su trabajo: el esquema de compromiso polinomial KZG.
Requiere curvas amigables para emparejamientos, y un setup confiable. Es definitivamente manejable, pero...
¿Qué pasaría si quisiéramos algo completamente transparente?
Esa es exactamente la pregunta que los STARKs nacieron para responder. ¡Así que esa será nuestra próxima parada!
¿Te resultó útil este contenido?
Apoya a Frank Mangone enviando un café. Todos los ingresos van directamente al autor.